Was, wenn der zuverlässigste Weg, Scraping-Blockaden zu reduzieren, nicht darin besteht, die IP zu wechseln, sondern das Verhalten Ihres Scrapers zu ändern? Wenn Jobs nach Anfragespitzen oder wiederholten Retries scheitern, liegt es nahe, nach einer Lösung auf Netzwerkebene zu suchen. Wer jedoch lernen will, wie man IP-Sperren beim Scraping vermeidet, beginnt mit Erlaubnis und Zurückhaltung, nicht mit dem Versuch, Aktivitäten vor einer Website zu verbergen, die diese bereits blockiert hat.
Ein planbarer Workflow beginnt damit, die Regeln der Website zu verstehen und nur Daten zu erheben, auf die Sie zugreifen dürfen. Steuern Sie die Anfragerate, begrenzen Sie die Parallelität und setzen Sie Retries aus, wenn ein Server signalisiert, dass er eine Pause braucht. Diese Schritte können vermeidbare Blockaden reduzieren, doch kein Setup kann den Zugriff garantieren.
Dieser Leitfaden zeigt, wie Sie eine verantwortungsvolle Datenerhebung planen, auf Rate Limits und Blockaden reagieren und entscheiden, wann Sie aufhören, Zugriff beantragen oder eine genehmigte Datenquelle nutzen sollten. Außerdem erklärt er, wo Mobile Proxys in autorisierte Workflows passen können und warum sie weder eine Erlaubnis ersetzen noch die Einschränkungen einer Website aufheben.
Das Wichtigste in Kürze
- Vermeiden Sie IP-Sperren beim Scraping, indem Sie festlegen, was Sie erheben dürfen, bevor Sie Ihren Scraper konfigurieren.
- Setzen Sie vorsichtige Anfragelimits, überwachen Sie Serverantworten und passen Sie die Parallelität an, um vermeidbare Blockaden zu reduzieren.
- Verstehen Sie, warum ein IP-Wechsel keine Erlaubnis erteilt und kein verantwortungsvolles Anfragemanagement ersetzt.
- Nutzen Sie bei einer Blockade einen klaren Reaktionsplan: pausieren, Diagnosedaten und Richtlinien der Website prüfen und, wo angemessen, eine Autorisierung einholen.
- Bauen Sie einen wiederverwendbaren Workflow mit definiertem Umfang, Monitoring, Abbruchbedingungen und einem Eskalationsweg für genehmigte Projekte auf.
Inhaltsverzeichnis
- IP-Sperren beim Scraping vermeiden beginnt mit einer Erlaubnis
- Scraping-Anfragen steuern, um vermeidbare Blockaden zu reduzieren
- Warum IP-Rotation allein keine Scraping-Sperren verhindert
- Was tun, wenn ein Scraper eine IP-Sperre erhält
- Einen regelkonformen Scraping-Workflow aufbauen, der zuverlässig bleibt
IP-Sperren beim Scraping vermeiden beginnt mit einer Erlaubnis
Eine IP-Sperre ist die Entscheidung einer Website, Anfragen einzuschränken, die mit einer bestimmten Internetadresse verbunden sind. Sie ist eine Maßnahme der Zugriffskontrolle und nicht bloß ein technischer Fehler, den man umgehen kann. Verantwortungsvolles Scraping bedeutet, nur Daten zu erheben, auf die Sie zugreifen dürfen, und die von der Website genannten Bedingungen einzuhalten. Sperrumgehung bedeutet, nach einer Zugriffsverweigerung weiterzumachen, zum Beispiel indem man die Netzwerkadresse wechselt, um eine ausdrückliche Sperre zu umgehen. Keine IP, kein Proxy und kein Anfragemuster garantiert den Zugriff.
Web-Scraping bezeichnet allgemein die automatisierte Extraktion von Informationen aus Websites. Diese Definition begründet keine Erlaubnis, Daten von einer bestimmten Website zu erheben. Öffentlich einsehbare Seiten, Inhalte hinter einer Anmeldung und untersagter automatisierter Zugriff sind unterschiedliche Situationen. Dass eine Seite ohne Login sichtbar ist, bedeutet nicht automatisch, dass jede Methode zur Erhebung oder Weiterverwendung ihrer Daten zulässig ist. Prüfen Sie die Nutzungsbedingungen der Website und die geltenden Regeln, bevor Sie einen Erhebungs-Workflow aufbauen.
Zugriffsregeln prüfen, bevor automatisierte Anfragen gesendet werden
Beginnen Sie mit den Nutzungsbedingungen der Website, den Vorgaben in der robots.txt, der API-Dokumentation und einer etwaigen veröffentlichten Crawl-Richtlinie. Betrachten Sie die robots.txt als Hinweis auf die Crawling-Präferenzen der Website, nicht als rechtliche Erlaubnis zur Datenerhebung. Wenn eine offizielle API oder ein Daten-Feed Ihren Bedarf deckt, nutzen Sie diese. Für Projekte, die über die veröffentlichten Freigaben hinaus Zugriff benötigen, holen Sie eine schriftliche Autorisierung ein, bevor Sie automatisierte Anfragen senden.
Dokumentieren Sie die erlaubten Seiten, Datenfelder, den Zweck und die Bedingungen, die Sie einhalten müssen. So erhält Ihr Scraper einen klaren Umfang, und Anfragen außerhalb des genehmigten Workflows lassen sich leichter erkennen. Ist die Richtlinie unklar, gehen Sie nicht davon aus, dass technische Erreichbarkeit eine Erlaubnis ist.
Signale erkennen, bei denen Sie aufhören sollten
Eine ausdrückliche Verweigerung, eine Zugriffskontroll-Challenge oder wiederholte Rate-Limit-Antworten erfordern eine Pause und Prüfung, keinen Versuch, die Einschränkung zu umgehen. Ein vorübergehender Dienstfehler kann eine andere Ursache haben, doch Unsicherheit ist kein Grund, denselben gesperrten Endpunkt weiter anzufragen. Pausieren Sie die Anfragen, prüfen Sie die Antwort und setzen Sie die Arbeit erst fort, wenn Sie das Problem verstehen und der Zugriff weiterhin erlaubt ist.
Führen Sie ein knappes Diagnoseprotokoll mit Antwortcode oder Meldung, Zeitstempel, Ziel-URL oder Endpunkt und der ergriffenen Maßnahme. Halten Sie zum Beispiel fest, ob der Scraper nach einer Rate-Limit-Antwort pausiert oder nach einer ausdrücklichen Verweigerung gestoppt hat. Dieses Protokoll hilft, vorübergehende Fehler von bewussten Einschränkungen zu unterscheiden, und unterstützt eine verantwortungsvolle Entscheidung, ob Sie warten, innerhalb der erlaubten Grenzen nachjustieren oder eine Autorisierung beantragen. Das ist die praktische Grundlage, um IP-Sperren beim Scraping zu vermeiden: die Grenzen der Website respektieren, statt Anfragen zu verschleiern.
Scraping-Anfragen steuern, um vermeidbare Blockaden zu reduzieren
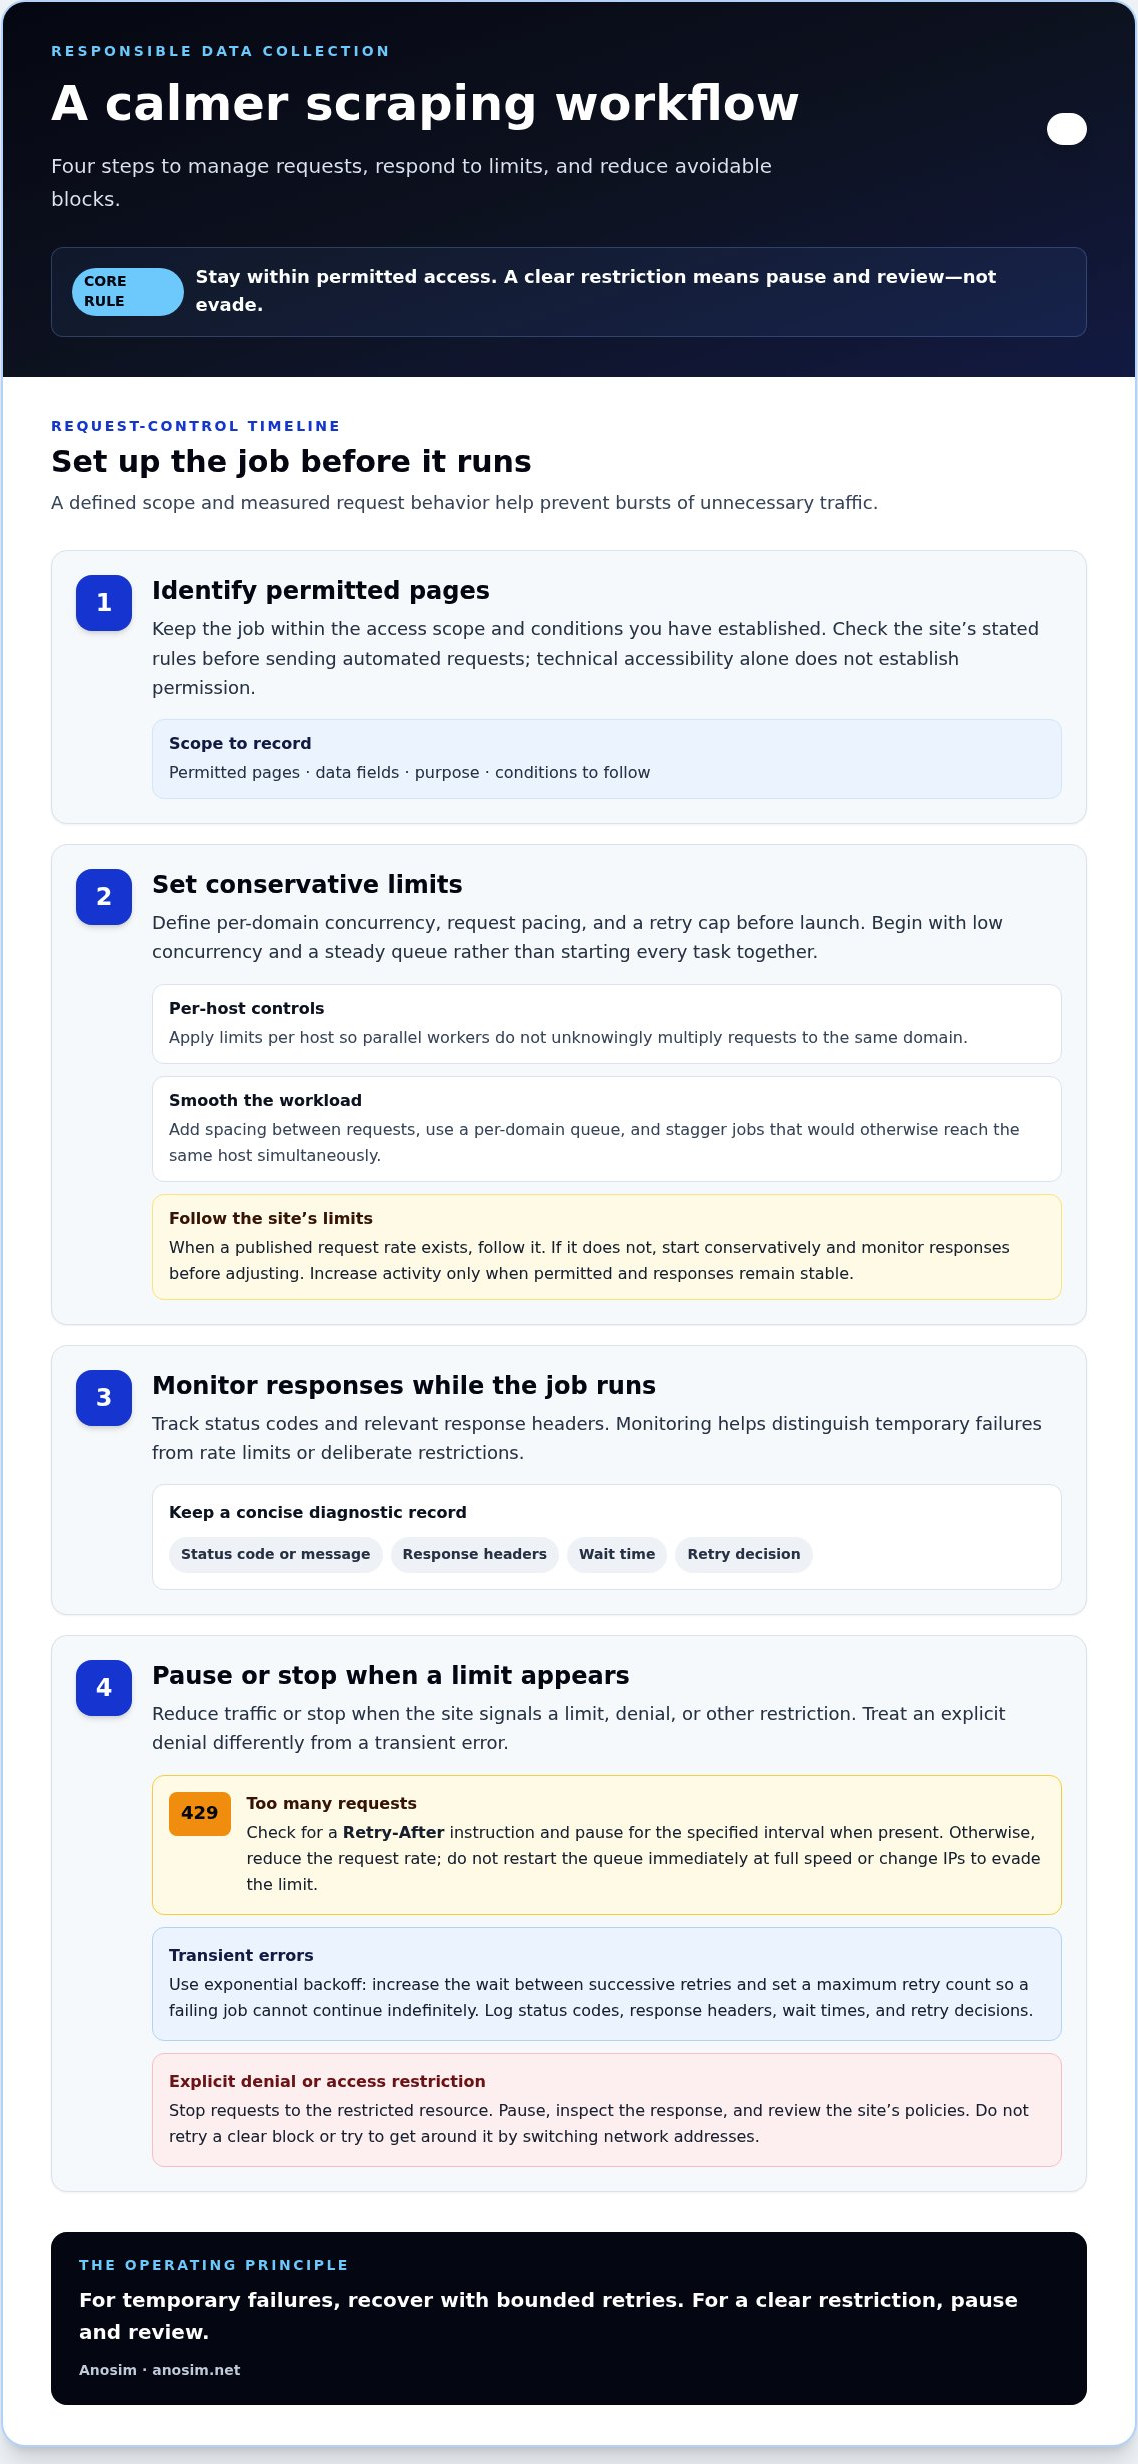
Eine sorgfältige Taktung macht die Datenerhebung planbarer und reduziert unnötige Last auf einer Website. Legen Sie vor dem Start eines Jobs seinen Umfang und sein Verhalten fest, damit eine langsame Antwort oder ein Rate Limit keine Welle von Retries auslöst. Gehen Sie dabei in dieser Reihenfolge vor:
- Erlaubte Seiten festlegen. Halten Sie den Job innerhalb des festgelegten Zugriffsumfangs und der vereinbarten Bedingungen.
- Vorsichtige Limits setzen. Definieren Sie vor dem Start die Parallelität pro Domain, die Anfragetaktung und eine Obergrenze für Retries.
- Antworten überwachen. Verfolgen Sie während der Laufzeit Statuscodes und relevante Response-Header.
- Bei Bedarf pausieren. Reduzieren Sie den Traffic oder stoppen Sie, wenn die Website ein Limit, eine Verweigerung oder eine andere Einschränkung signalisiert.
Übermäßige Parallelität kann viele Anfragen gleichzeitig an einen Host senden. Plötzliche Spitzen und synchronisierte Jobs können ebenfalls unnötige Last erzeugen und Schutzmechanismen auslösen. Eine Warteschlange pro Domain hilft, die Nachfrage zu glätten, und alle Anpassungen sollten innerhalb der veröffentlichten Limits der Website bleiben. Gibt eine Website eine Anfragerate vor, halten Sie sich daran. Wenn nicht, beginnen Sie vorsichtig und beobachten Sie die Antworten, bevor Sie etwas ändern.
Vorsichtige Taktung und Parallelität festlegen
Beginnen Sie mit geringer Parallelität und einer gleichmäßigen Warteschlange, statt alle Aufgaben gleichzeitig zu starten. Setzen Sie Limits pro Host und nicht nur für den gesamten Scraper, damit parallele Worker die Anfragen an dieselbe Domain nicht unbemerkt vervielfachen. Fügen Sie Abstände zwischen den Anfragen ein und staffeln Sie geplante Jobs, die sonst gleichzeitig denselben Host treffen würden. Erhöhen Sie die Aktivität nur, wenn dies erlaubt ist und die Antworten stabil bleiben. Sieht die Richtlinie der Website eine niedrigere Rate vor, halten Sie sich an dieses Limit.
HTTP 429 und andere Sperrsignale sorgfältig behandeln
HTTP 429 zeigt an, dass der Client innerhalb eines bestimmten Zeitraums zu viele Anfragen gesendet hat. Prüfen Sie die Antwort auf eine Retry-After-Anweisung und pausieren Sie, falls vorhanden, für das angegebene Intervall. Andernfalls reduzieren Sie die Anfragerate und starten Sie die Warteschlange nicht sofort wieder mit voller Geschwindigkeit. Wechseln Sie nicht die IP, um ein Rate Limit zu umgehen.
Bei vorübergehenden Fehlern verwenden Sie exponentielles Backoff: Erhöhen Sie die Wartezeit zwischen aufeinanderfolgenden Retries und legen Sie eine maximale Anzahl an Retries fest, damit ein fehlschlagender Job nicht endlos weiterläuft. Protokollieren Sie Statuscodes, Response-Header, Wartezeiten und Retry-Entscheidungen, damit sich Fehler diagnostizieren lassen. Behandeln Sie eine ausdrückliche Verweigerung anders: Stoppen Sie die Anfragen an die gesperrte Ressource, statt sie erneut zu versuchen.
Nach einer eindeutigen Sperre noch hartnäckiger neu zu versuchen, ist keine verantwortungsvolle Wiederherstellung. In der Praxis bedeutet IP-Sperren beim Scraping vermeiden zum Teil, dass der Scraper auf Limits mit weniger Traffic reagiert, nicht mit mehr. Eine begrenzte Retry-Strategie kann bei vorübergehenden Fehlern helfen. Eine eindeutige Einschränkung erfordert eine Pause und Prüfung.
Warum IP-Rotation allein keine Scraping-Sperren verhindert
Ein Wechsel der IP-Adresse ändert den Weg, den eine Anfrage nimmt. Er ändert nichts daran, ob die Website diese Anfrage erlaubt, erweitert nicht die Seiten, auf die Sie zugreifen dürfen, und hebt keine bestehende Einschränkung auf. Websites bewerten Aktivitäten unter Umständen anhand von Anfragemustern, Sessions, Kontokontext und weiteren Signalen, daher kann ein Adresswechsel allein den Zugriff nicht sicherstellen. Um zu verstehen, wie Sie IP-Sperren beim Scraping vermeiden, sollten autorisierter Zugriff und kontrolliertes Anfrageverhalten Vorrang vor Netzwerkänderungen haben.
Nutzen Sie Netzwerkinfrastruktur nur für einen legitimen, erlaubten Zweck. Mobile Proxys leiten Traffic über Mobilfunk-Infrastruktur, was für autorisierte Netzwerktests oder Abläufe nützlich sein kann, die diesen Weg tatsächlich benötigen. Ebenso verschlüsseln Dienste wie VPN Secure den Internetverkehr geräteübergreifend, um die allgemeine Netzwerkkommunikation zu schützen. Doch weder ein VPN noch ein Proxy setzt die Nutzungsbedingungen einer Website außer Kraft, hebt eine Verweigerung auf oder garantiert ununterbrochenen Zugriff. Wenn eine Website Anfragen blockiert oder eine Challenge stellt, rotieren Sie keine Adressen, um trotz dieser Einschränkung weiterzumachen.
Was Mobile Proxys leisten können und was nicht
Ein Proxy sitzt zwischen einem Client und einem Ziel und leitet den Traffic über eine andere Netzwerkverbindung. Das kann genehmigte Tests in unterschiedlichen Netzwerkumgebungen unterstützen, erteilt aber keine Erlaubnis zum Scraping. Selbst in fortgeschrittenen Unternehmensszenarien, etwa beim Einsatz von Quantum Infinity für Stealth-Tunneling, gelten die Zugriffsregeln und Kontrollen der Website weiterhin. Betrachten Sie Proxy- und Netzwerkinfrastruktur als eine Komponente eines autorisierten Workflows, nicht als Mittel, eine Sperre auszuhebeln oder eine untersagte Erhebung zu verschleiern.
- Anfragetaktung und Limits pro Domain: Der legitime Zweck besteht darin, eine autorisierte Erhebung kontrolliert zu halten und vermeidbare Last zu reduzieren; die wichtige Einschränkung ist, dass sie keine Erhebung über die Regeln der Website hinaus erlaubt.
- Offizielle API oder genehmigter Daten-Feed: Der legitime Zweck besteht darin, Daten über einen dafür vorgesehenen Weg abzurufen; die wichtige Einschränkung ist, dessen Umfang, Bedingungen und Nutzungslimits einzuhalten.
- Schriftliche Erlaubnis oder Vereinbarung mit festgelegtem Umfang: Der legitime Zweck besteht darin, den Zugriff für eingeschränkte oder umfangreiche Projekte zu klären; die wichtige Einschränkung ist, innerhalb der vereinbarten Seiten, Daten und Bedingungen zu bleiben.
- Mobile-Proxy-Infrastruktur: Der legitime Zweck besteht darin, autorisierte Netzwerktests oder Abläufe zu unterstützen; die wichtige Einschränkung ist, dass sie den Netzwerkweg ändert, nicht die Erlaubnis oder Zugriffsentscheidungen.
Den richtigen Weg für legitimen Datenzugriff wählen
Wenn eine offizielle API oder ein genehmigter Feed die benötigten Informationen abdeckt, nutzen Sie diesen Weg und halten Sie die dokumentierten Limits ein. Für eingeschränkte Seiten oder eine umfangreiche Erhebung holen Sie eine schriftliche Autorisierung ein und definieren den Projektumfang, bevor Sie einen Scraper starten. Ziehen Sie Proxy-Infrastruktur nur in Betracht, wenn ein genehmigter Workflow einen echten Netzwerkbedarf hat. Wird der Zugriff verweigert, stoppen Sie und klären Sie die Autorisierung, statt die IP zu wechseln, um weiter Daten zu erheben.
Die Unterscheidung ist einfach: Anfragekontrollen bestimmen, wie sich eine autorisierte Erhebung verhält, während IP-Wechsel nur den Verbindungsweg ändern. Weder eine neue Adresse noch ein Proxy macht aus einer untersagten Anfrage eine erlaubte.
Was tun, wenn ein Scraper eine IP-Sperre erhält
Eine Sperre ist ein Signal, anzuhalten und die Ursache zu untersuchen, keine Aufforderung, die Adresse zu wechseln und es erneut zu versuchen. Pausieren Sie zuerst den betroffenen Job. Erfassen Sie dann genügend Informationen, um zu verstehen, was passiert ist, prüfen Sie die Zugriffsrichtlinie der Website und entscheiden Sie, ob die Erhebung über einen autorisierten Weg fortgesetzt werden kann.
- Erhebung pausieren. Stoppen Sie die Worker, die den betroffenen Host ansprechen, damit Retries und geplante Jobs keinen zusätzlichen Traffic erzeugen.
- Diagnosedaten erfassen. Protokollieren Sie Antwortcode und Meldung, Zeitstempel, Ziel-URL, Anfragevolumen und relevante Response-Header.
- Ursache und Richtlinie prüfen. Prüfen Sie, ob die Antwort nach einem vorübergehenden Rate Limit oder einer ausdrücklichen Verweigerung aussieht, und suchen Sie nach veröffentlichten Anweisungen zur Wiederherstellung.
- Einen erlaubten nächsten Schritt wählen. Holen Sie, wo angemessen, eine Autorisierung ein, oder entfernen Sie das Ziel aus dem Job und nutzen Sie eine genehmigte Datenquelle.
Eine Rate-Limit-Antwort kann darauf hindeuten, dass die Anfragetaktung überprüft werden muss, während eine ausdrückliche Verweigerung auf einen eingeschränkten Zugriff hinweist. Fragen Sie den Endpunkt nicht wiederholt an, um herauszufinden, was davon zutrifft. Ist die Antwort unklar, lassen Sie den Job pausiert und nutzen Sie die veröffentlichten Hinweise der Website oder einen geeigneten Kontaktweg.
Die Antwort diagnostizieren, ohne den Traffic zu erhöhen
Prüfen Sie anhand der Logs, ob ein Konfigurationsfehler, eine unbeabsichtigte Anfrageschleife oder zu viele parallele Aufgaben auf einen Host vorliegen. Vergleichen Sie das protokollierte Anfragevolumen und die Zeitstempel mit dem Job-Zeitplan. So lässt sich erkennen, ob ein Crawler fehlgeschlagene Anfragen zu schnell wiederholt hat oder mehrere Worker gleichzeitig liefen. Wechseln Sie nach einer ausdrücklichen Verweigerung weder IP-Adressen noch Konten, um weiterzumachen. Das löst die Einschränkung nicht.
Nur über einen autorisierten Weg fortfahren
Befolgen Sie veröffentlichte Anweisungen zur Wiederherstellung oder beantragen Sie eine schriftliche Erlaubnis beim Websitebetreiber, wenn das Projekt weiterhin Zugriff benötigt. Wird die Erlaubnis verweigert, beenden Sie die Erhebung von diesem Ziel und ziehen Sie eine offizielle API oder einen lizenzierten Datensatz in Betracht, der die benötigten Informationen abdeckt. Dokumentieren Sie vor jedem erlaubten Neustart die Korrekturmaßnahme, etwa eine geringere Parallelität, eine behobene Schleife oder einen geänderten Job-Umfang. Legen Sie eine klare Abbruchbedingung fest, damit derselbe Fehler keine unkontrollierten Retries auslöst.
Wenn ein autorisierter Workflow tatsächlich Mobilfunk-Infrastruktur benötigt, lesen Sie den technischen Leitfaden von Anosim zu Mobile Proxys. Ein Proxy kann einen legitimen Netzwerk-Anwendungsfall unterstützen, erteilt aber keine Erlaubnis zum Scraping und garantiert keinen Zugriff. Ein disziplinierter Ablauf aus Pausieren und Prüfen ist ein praktischer Bestandteil, um IP-Sperren beim Scraping zu vermeiden, und verhindert, dass die Wiederherstellung zum Versuch wird, die Kontrollen einer Website zu umgehen.
Einen regelkonformen Scraping-Workflow aufbauen, der zuverlässig bleibt
Ein zuverlässiger Workflow macht die Betriebsregeln sowohl für den Scraper als auch für die verantwortlichen Personen sichtbar. Dokumentieren Sie jede Datenquelle, die Seiten und Felder im Umfang, die Zugriffsbedingungen und die Person oder das Team, das Fragen klärt. Aktualisieren Sie diese Dokumentation, wenn sich Berechtigungen, Richtlinien der Website oder Job-Einstellungen ändern. Sie gibt den Verantwortlichen eine klare Referenz, wenn sich ein Erhebungsjob unerwartet verhält.
Nutzen Sie diese Checkliste vor dem Start und bei regelmäßigen Überprüfungen:
- Erlaubnis: Bestätigen Sie, dass der Zugriffsweg erlaubt ist, und bewahren Sie schriftliche Autorisierungen oder genehmigte API-Bedingungen auf.
- Umfang: Listen Sie erlaubte Seiten, Datenfelder, Zweck und Ausschlüsse auf. Verhindern Sie, dass der Job über diesen Umfang hinauswächst.
- Anfragelimits: Legen Sie in der Job-Konfiguration Taktung pro Domain, Parallelitätslimits und begrenzte Retries fest.
- Monitoring: Verfolgen Sie auf Job-Ebene Anfragevolumen, Antwortcodes, Fehlerraten und Pausen.
- Abbruchbedingungen: Verhindern Sie automatische Retries nach einer ausdrücklichen Verweigerung oder Zugriffsbeschränkung.
- Eskalation: Halten Sie für genehmigte Projekte einen Kontaktweg bereit, damit die Verantwortlichen wissen, wohin sie Zugriffsfragen oder unerwartete Einschränkungen richten.
Dokumentieren Sie Änderungen, sobald sie erfolgen. Halten Sie zum Beispiel fest, warum ein Anfragelimit angepasst wurde, welche Job-Version sich geändert hat und wer eine Erweiterung des Umfangs genehmigt hat. Dieser Verlauf hilft, eine bewusste, autorisierte Änderung von einer versehentlichen Konfigurationsabweichung zu unterscheiden.
Jobs überwachen und Abbruchbedingungen eindeutig festlegen
Monitoring sollte zu einer definierten Maßnahme führen, nicht nur zu einem Dashboard. Richten Sie Warnmeldungen für wiederholte Rate Limits, Zugriffsverweigerungen, steigende Fehlerraten oder unerwartet pausierende Jobs ein. Konfigurieren Sie ausdrückliche Einschränkungen so, dass sie Anfragen an das betroffene Ziel stoppen und vor jedem Neustart eine Prüfung durch die Verantwortlichen erfordern. So verhindern Sie, dass eine Retry-Schleife aus einer einzelnen Antwort dauerhaft unerwünschten Traffic macht.
Netzwerkinfrastruktur nur im genehmigten Umfang nutzen
Wählen Sie Netzwerkinfrastruktur nach dokumentierten betrieblichen Anforderungen aus, nicht, um weiterzumachen, nachdem eine Website den Zugriff verweigert hat. Mobile Proxys können für autorisierte Netzwerk-Anwendungsfälle relevant sein, erteilen aber keine Erlaubnis und garantieren keinen Zugriff. Lesen Sie die Informationen zum Mobile-Proxy-Dienst nur, wenn diese Infrastruktur zu einem genehmigten Workflow passt. Für Integrationsdetails zu den Diensten von Anosim ziehen Sie die API-Dokumentation von Anosim heran. Eine API-Dokumentation berechtigt nicht zum Scraping einer Drittanbieter-Website. Verlangt eine Plattform zusätzlich eine Telefonnummer, bietet Anosim Einmalnummern für die SMS-Verifizierung.
Die praktische Antwort darauf, wie Sie IP-Sperren beim Scraping vermeiden, lautet: klare Grenzen, maßvolle Anfragekontrollen und einen verlässlichen Abbruchweg einbauen. Wenn sich Erhebungsregeln oder Zugriffsbedingungen ändern, pausieren Sie den betroffenen Job, aktualisieren Sie seinen dokumentierten Umfang und fahren Sie nur über einen autorisierten Weg fort.
Verantwortungsvolles Scraping zum Teil des Workflows machen
Eine zuverlässige Erhebung hängt von einer klaren Erlaubnis, kontrollierten Anfragen und einer festgelegten Reaktion ab, wenn eine Website ein Limit signalisiert oder den Zugriff verweigert. Die praktische Antwort darauf, wie Sie IP-Sperren beim Scraping vermeiden, besteht nicht darin, den Scraper zu verstecken. Bleiben Sie im genehmigten Umfang, überwachen Sie das Verhalten der Jobs und stoppen Sie, wenn der Zugriff eingeschränkt wird.
Dokumentieren Sie Quellrichtlinien, Autorisierungen, Anfragelimits und Eskalationsschritte, damit Ihr Team Fehler diagnostizieren und Änderungen sorgfältig vornehmen kann. IP-Rotation allein gewährt keinen Zugriff und hindert eine Website nicht daran, Anfragen einzuschränken. Der Zugang zu Mobile Proxys über den Anosim-Partner proxied.com kann autorisierte Netzwerkanforderungen unterstützen, während die API-Dokumentation den Integrationskontext für die Dienste von Anosim liefert. Keines von beiden ersetzt die Erlaubnis, Daten von einer Website zu erheben.
Wenn Ihr genehmigter Workflow einen echten Bedarf an Netzwerkinfrastruktur hat, entdecken Sie die Mobile Proxys von proxied.com für autorisierte Workflows. Bauen Sie zuerst die Grenzen ein, damit Sie die Erhebung planbar und verantwortungsvoll halten können.
Häufig gestellte Fragen
Können rotierende Proxys eine IP-Sperre beim Scraping verhindern?
Nein. Rotierende Proxys können eine Website nicht daran hindern, den Zugriff einzuschränken, und machen untersagtes Scraping nicht zulässig. Ein Proxy ändert den Netzwerkweg, nicht Ihre Autorisierung. Websites berücksichtigen unter Umständen auch Anfragemuster, Sessions oder Kontokontext, sodass ein Adresswechsel eine Sperre möglicherweise nicht aufhebt. Nutzen Sie Proxy-Infrastruktur nur für einen autorisierten Netzwerkbedarf und rotieren Sie keine IPs, um nach einer ausdrücklichen Verweigerung weiterzumachen oder Zugriffskontrollen zu umgehen.
Ist Web-Scraping legal, wenn die Informationen öffentlich verfügbar sind?
Öffentliche Verfügbarkeit macht nicht automatisch jede Scraping-Aktivität rechtmäßig. In den Vereinigten Staaten wird die Erhebung öffentlich zugänglicher Daten in der Regel anders behandelt als der Zugriff auf Daten hinter einer Authentifizierung, doch es können weitere Aspekte greifen, darunter von Ihnen akzeptierte Vertragsbedingungen und Datenschutzvorschriften. Rechtliche Ergebnisse hängen vom Sachverhalt und von der Rechtsordnung ab. Prüfen Sie die Nutzungsbedingungen der Website und die geltenden Anforderungen, und holen Sie bei einem Projekt mit erheblichem Risiko qualifizierten Rechtsrat ein.
Was sollte ich tun, wenn eine Website HTTP 429 zurückgibt?
HTTP 429 bedeutet, dass der Server Anfragen per Rate Limiting begrenzt. Pausieren oder reduzieren Sie daher den Traffic, statt die Parallelität zu erhöhen oder die IP zu wechseln. Prüfen Sie die Antwort auf eine Retry-After-Anweisung und befolgen Sie diese. Ist keine angegeben, warten Sie vor dem nächsten erlaubten Versuch, nutzen Sie begrenzte Retries für vorübergehende Fehler und protokollieren Sie die Details der Antwort. Stoppen Sie, wenn die Rate Limits anhalten oder die Website anzeigt, dass der Zugriff verweigert wird.
Wie erkenne ich, ob mein Scraper blockiert wird oder die Website vorübergehend nicht erreichbar ist?
Prüfen Sie Antwortcode und Meldung, relevante Header und ob der Fehler einen einzelnen Endpunkt oder die gesamte Website betrifft. Eine ausdrückliche Verweigerung, eine Zugriffskontroll-Challenge oder wiederholte Rate-Limit-Antworten deuten auf eine Einschränkung hin. Ein Dienstfehler kann vorübergehend sein, ist aber kein Beleg dafür, dass weitere Anfragen erwünscht sind. Protokollieren Sie Zeitstempel und Ziel, pausieren Sie den betroffenen Job und ziehen Sie die veröffentlichten Hinweise heran. Fragen Sie einen gesperrten Endpunkt nicht wiederholt an, um ihn zu testen.
Erteilt die robots.txt eine Erlaubnis zum Scraping einer Website?
Nein. Eine robots.txt-Datei teilt Crawling-Präferenzen mit und kann Pfade benennen, die automatisierte Crawler meiden sollen, erteilt aber keine rechtliche Erlaubnis, Daten zu erheben oder weiterzuverwenden. Prüfen Sie sie zusammen mit den Nutzungsbedingungen, der Crawl-Richtlinie und der API-Dokumentation der Website. Bleiben die Zugriffsbedingungen unklar oder geht Ihre geplante Erhebung über die veröffentlichten Hinweise hinaus, nutzen Sie einen genehmigten Datenweg oder holen Sie vor dem Fortfahren eine Autorisierung ein.
Kann eine Website einen Scraper anhand von Signalen jenseits der IP-Adresse blockieren?
Ja. Eine Website kann Anfragemuster, Sessions, Kontokontext oder andere Signale berücksichtigen, wenn sie entscheidet, ob sie den Zugriff einschränkt. Die genauen Kontrollen unterscheiden sich von Website zu Website und sind für einen Scraper nicht immer erkennbar. Deshalb kann IP-Rotation allein keinen fortgesetzten Zugriff sicherstellen. Halten Sie Anfragen im erlaubten Umfang, reagieren Sie sorgfältig auf Rate Limits und betrachten Sie eine Zugriffs-Challenge oder ausdrückliche Verweigerung als Grund, zu pausieren und zu prüfen.
Wann sollte ich das Scraping beenden und eine Erlaubnis beantragen?
Stoppen Sie, wenn die Website den Zugriff ausdrücklich verweigert, eine Zugriffskontroll-Challenge stellt, Anfragen wiederholt per Rate Limit begrenzt oder ihre veröffentlichte Richtlinie Ihre geplante Aktivität untersagt. Pausieren Sie den Job, protokollieren Sie die Antwort und relevante Diagnosedaten und prüfen Sie dann die Nutzungsbedingungen und Wiederherstellungshinweise der Website. Benötigt das Projekt weiterhin Zugriff, holen Sie vor dem Neustart eine schriftliche Autorisierung ein. Wird keine Erlaubnis erteilt, entfernen Sie das Ziel und ziehen Sie eine offizielle API, einen genehmigten Feed oder einen lizenzierten Datensatz in Betracht.